
فهمیدن یک فرمان طبیعی توسط مدل به معنای مجازبودن اجرای آن در یک سیستم سازمانی نیست. این مقاله مسیر ساخت آزمایشی یک پرتال مدیریت وظایف را توضیح میدهد و میان امکانات تستشده و کنترلهای امنیتیِ هنوز تکمیلنشده تفاوت میگذارد.
فهمیدن یک دستور، با مجوز اجرای آن فرق دارد
تصور کنید مدیری به یک دستیار هوش مصنوعی بگوید: «این وظیفه انجامشده را تأیید کن». تشخیص منظور جمله برای یک مدل زبانی میتواند ساده باشد؛ اما اجرای واقعی آن در سازمان نیازمند تشخیص هویت فرد، پیدا کردن وظیفه درست، بررسی سطح دسترسی، تأیید وضعیت فعلی و ثبت قابلپیگیری نتیجه است.
این فاصله بین درک درخواست و اجرای امن اقدام، یکی از مسئلههایی است که هنگام توسعه یک پرتال مدیریتی مبتنی بر AI بررسی میکنم.
این نوشته درباره یک سامانه در حال توسعه است؛ نه محصولی که همه بخشهای آن عملیاتی و آماده Production باشد. برای حفاظت از اطلاعات سازمانی، نمودار و تمام سناریوهای این مقاله مفهومی و ساختگی هستند. همچنین وضعیت قابلیتها بر اساس آخرین مستند فنیِ تاریخدار بررسی شده، نه ممیزی زنده محیط عملیاتی.
ابتدا فرایند را طراحی کنیم، بعد مدل را به آن وصل کنیم
هدف این است که یک مدیر بتواند درخواستش را با زبان طبیعی بیان کند و دستیار برای پیدا کردن وظیفه یا آمادهکردن پیشنهاد ساختاریافته کمک کند. اما نقطه حساس، زمانی است که نرمافزار باید تصمیم بگیرد آیا مجاز به اجرای آن درخواست هست یا خیر.
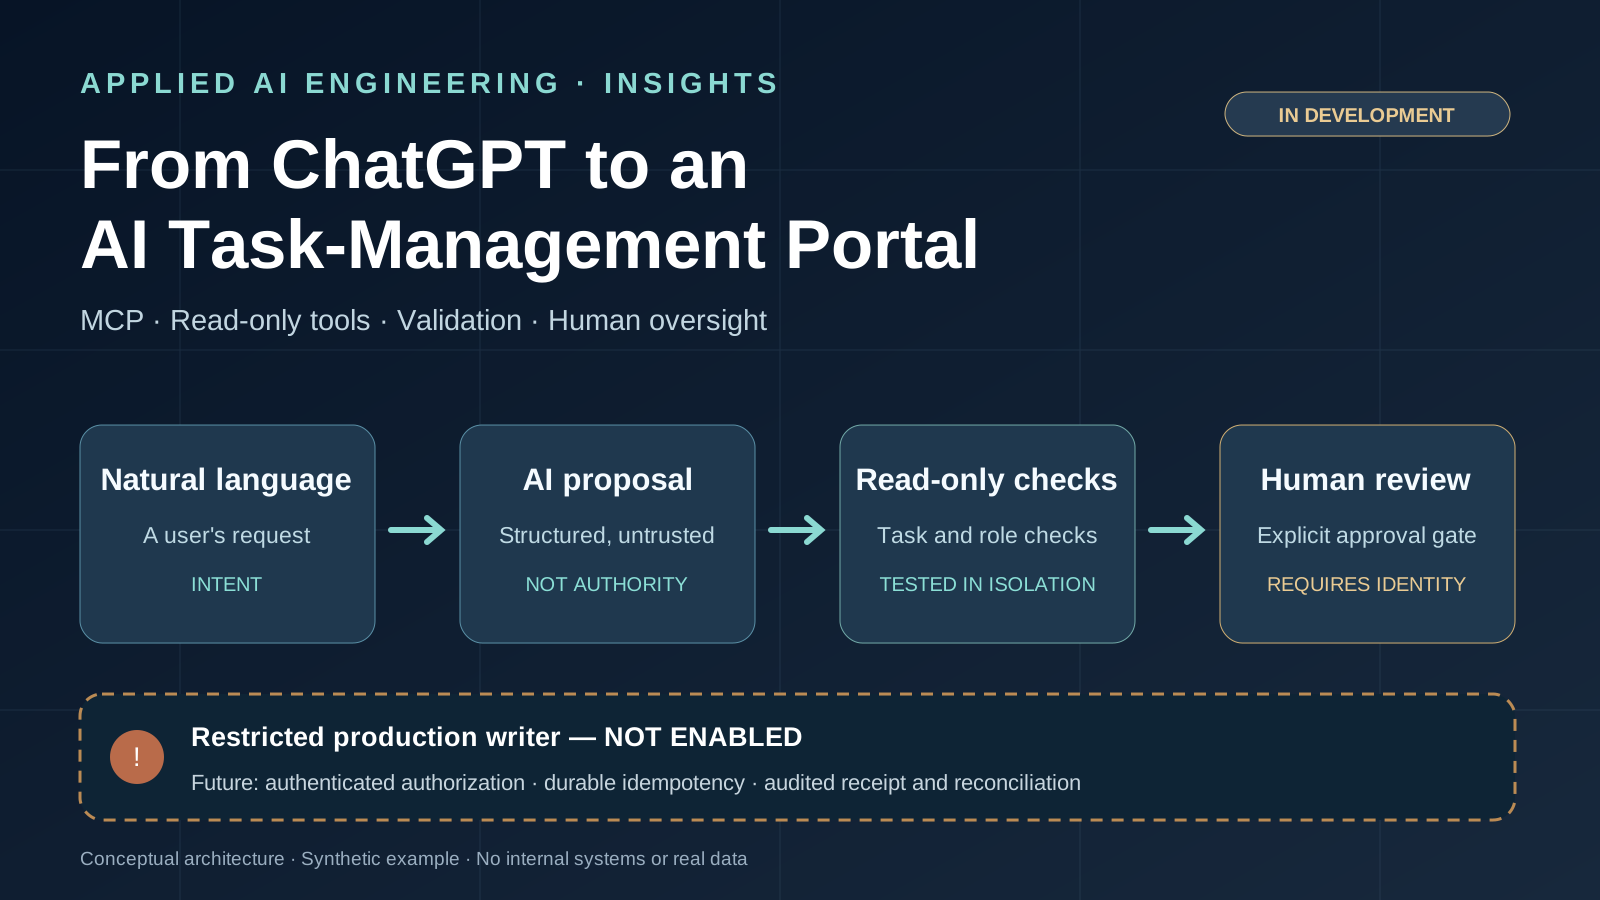
این جریان را میتوان به چهار مرحله تقسیم کرد:
- فهم درخواست: مشخصکردن هدف و پرسیدن اطلاعات ناقص؛ بدون حدسزدن نام مسئول، شناسه وظیفه یا مجوز کاربر.
- بازیابی: خواندن وضعیت وظایف از ابزارهای محدود و فقطخواندنی.
- آمادهسازی تصمیم: اعتبارسنجی شناسهها، وضعیت و مجوزها و نمایش پیشنمایش قابلفهم.
- اجرا و تطبیق نتیجه: فقط پس از تأیید هویت، مجوز لازم و تأیید انسانی، ارسال دستور از مسیر محدود و ثبت نتیجه واقعی.
این مراحل از نظر سطح اعتماد یکسان نیستند. پیشنهادی که مدل میسازد، مدرک مجازبودن کاربر نیست. همچنین نمایش دکمه «تأیید» در Frontend بهتنهایی یک کنترل امنیتی محسوب نمیشود.
MCP دقیقاً چه کمکی میکند؟
پروتکل MCP امکان تعریف و فراخوانی استانداردتر ابزارهایی را فراهم میکند که دستیار به آنها متصل میشود. در یک سامانه مدیریت وظایف، چنین ابزاری ممکن است اطلاعات یک وظیفه یا وضعیت یک برد را بازیابی کند.
اما MCP بهتنهایی سامانه احراز هویت یا کنترل مجوز اجرای عملیات نیست. خود برنامه باید تعیین کند چه ابزاری فقط داده میخواند، چه اقدامی نیازمند مجوز است و کدام عملیات فعلاً باید ممنوع بماند.
در مسیر آزمایشی فعلی، پیشرفتهای مستند عمدتاً مربوط به خواندن اطلاعات وظیفه، کنترل تطابق آن با برد مورد انتظار و آمادهسازی پیشنمایش تصمیم بودهاند. اینها گامهای ارزشمند هستند، اما به معنای فعالشدن خودکار تأیید یا رد وظایف واقعی نیستند.
چه چیزهایی ساخته شده و چه چیزهایی هنوز باقی ماندهاند؟
آخرین Checkpoint فنیِ قابلاستناد برای نگارش این مطلب، از محیط پیشنمایش ایزوله، آزمایش نمایش تصمیم در نقشهای متفاوت و یک ابزار خط فرمان برای بررسی فقطخواندنی صحبت میکند. این شواهد، گزارش محیط آزمایشی در تاریخ مشخص هستند؛ نه گواه آمادهبودن Production.
| قابلیت | وضعیت مستند |
|---|---|
| رابط آزمایشی پرتال و دکمههای پیشنمایش تصمیم | در محیط تست نمایش و بررسی شده |
| خواندن وظایف و بردها | در یک بررسی فقطخواندنی تاریخدار کنترل شده |
| بررسی اولیه هویت وظیفه و وضعیت آن، همراه با ردپا در لاگ محلی | در ابزار خط فرمان آزمایش شده |
| اتصال همان Preflight به Endpoint تصمیم در پرتال | در Checkpoint مربوطه هنوز تکمیل نشده |
| احراز هویت مستقل مدیرعامل و کنترلهای امنیتی مناسب محیط واقعی | نیازمند تکمیل |
| جلوگیری پایدار از اجرای تکراری یک تصمیم و تطبیق نتیجه عملیات | هنوز تکمیلشده گزارش نشده |
| اجرای عمومی تأیید یا رد واقعی وظیفه از طریق مکالمه | فعال و تأییدشده نیست |
موفقیت در خواندن و پیشنمایش یعنی سیستم میتواند تصمیم را آماده کند؛ نه اینکه اجازه اجرای آن را گرفته باشد.
سه درس مهندسی
۱. دسترسی فقطخواندنی خودش یک دستاورد مهم است
در نمایشهای جذاب هوش مصنوعی، معمولاً نخستین چیزی که میبینیم اجرای یک دستور است. اما بهتر است ابتدا پاسخ سؤالهای ساده را قابلاعتماد کنیم: آیا وظیفه وجود دارد؟ آیا در برد مورد انتظار است؟ آیا واقعاً تکمیل شده؟ آیا اطلاعاتی که میبینیم تازه است؟
اینجا مفهوم منشأ داده یا Data Provenance اهمیت پیدا میکند. خلاصهای که از Snapshot قدیمی ساخته شده، نباید با وضعیت تازه و تأییدشده تفاوتناپذیر باشد.
البته دسترسی فقطخواندنی هم بدون کنترل محرمانگی و سطح دسترسی ایمن نیست؛ فقط دامنه پیامد خطا را در دوره توسعه محدودتر میکند.
۲. اعتبارسنجی نباید به تشخیص مدل محدود شود
مدل میتواند پیشنهاد ساختاریافته بسازد، اما برنامه باید به شکل قطعی بررسی کند شناسه وظیفه معتبر است، کاربر در محدوده مجاز قرار دارد، وضعیت عملیات درست است و داده تازهخوانی شده است.
برای اقدام واقعی، وجود تأیید انسانی کافی نیست مگر اینکه آن تأیید به یک هویت احرازشده، یک وظیفه مشخص و وضعیت قابلاعتماد همان لحظه متصل باشد.
۳. تکرار درخواست، همیشه راهحل خطا نیست
فرض کنیم درخواست ارسال شود، ولی پاسخ شبکه برنگردد. آیا تغییر انجام شده یا نه؟ اگر نرمافزار همان فرمان را دوباره بفرستد، ممکن است با اجرای تکراری و نتیجه ناخواسته مواجه شود.
در چنین حالتی به Idempotency، رسید قابلپیگیری و فرایند تطبیق نتیجه نیاز داریم. تست فعلی، محافظت محدود در برابر تکرار یک شناسه درخواست را نشان داده است؛ ولی جلوگیری کامل از تصمیم تکراری برای یک وظیفه با شناسههای متفاوت هنوز اثبات نشده است.
این محدودیت یک مورد باز در توسعه است، نه قابلیتی که آن را تمامشده معرفی کنیم.
معماری مفهومی و مرز اعتماد
برای یک مثال کاملاً ساختگی، مسیر موردنظر چنین است:
درخواست طبیعی کاربر
↓
تفسیر و پیشنهاد ساختاریافته توسط AI
↓
API قابلاعتماد و کنترل ورودی و مجوز
↓
بازیابی فقطخواندنی و بررسی وضعیت
↓
پیشنمایش تصمیم و تأیید انسانی
↓
[در آینده] اجرای محدود + رسید و تطبیق نتیجهقرارگرفتن یک مرحله در نمودار به معنای پیادهسازی کامل آن نیست. به همین دلیل بخش اجرای نهایی در این تصویر یک جزء آینده محسوب میشود.
این تفکیک به طراحی تستها نیز کمک میکند: درخواست ناقص باید رد شود، داده خارج از محدوده نباید نمایش داده شود، تصمیم منقضی نباید اجرا شود و نتیجه نامشخص نباید بهصورت موفقیت قطعی ثبت شود.
گام بعدی توسعه
اولویت کوتاهمدت، وصلکردن ابزار Preflight فقطخواندنی به رابط پیشنمایش ایزوله از یک مسیر محدود و بررسیشده است؛ بدون فعالکردن امکان نوشتن عمومی روی سیستم وظایف.
پس از آن، احراز هویت مستقل، کنترل سطح دسترسی، بررسی همزمانی تصمیمها، ثبت رخداد و یک مسیر اجرای بسیار محدود باید طراحی و جداگانه تست شوند.
برای من، نکته اصلی این تجربه فراتر از انتخاب Python یا MCP است:
ساختن سیستم AI قابلاعتماد، به اندازه توانایی فهم زبان، به محدودکردن اختیارات، شواهد و مدیریت خطا وابسته است.
وصلکردن یک مدل به ابزارها شروع کار است. مهندسی واقعی این است که بتوانیم به استفاده درست و قابلپیگیری از آن ابزارها اعتماد کنیم.